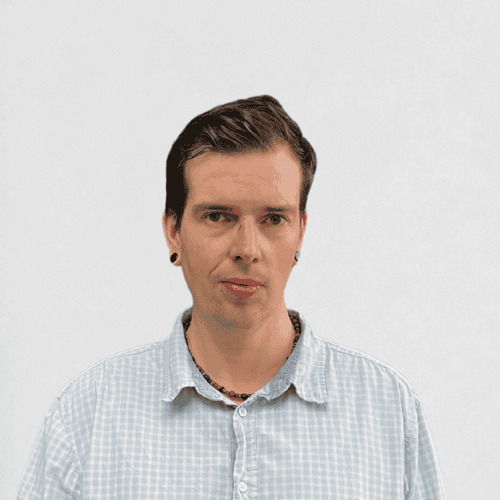
Portrait of Christian Häusler
Scheer, Deutschland
Hallo, ich bin

Christian Häusler

n8n Workflow-Entwickler – Automatisierung, API-Integration & KI-Anbindung

Ich konzipiere und entwickle Automations-Workflows in n8n, binde Drittanbieter-Anwendungen über REST-APIs und Webhooks ein und integriere KI-Komponenten wie LLM-Anbindungen in bestehende Prozesse. Mit Fachabteilungen identifiziere ich Automatisierungspotenziale und setze effiziente Lösungen um – von der Workflow-Entwicklung bis zum Self-Hosting mit Docker.

Photo / Pexels

Über mich

IT-Allrounder mit Fokus auf Automatisierung und KI-Integration – ich verbinde klassische IT-Administration mit moderner Workflow-Automatisierung und KI-Technologien. Mit Hintergrund in Windows-IT-Administration und IT-Service/Support habe ich mich in den letzten Jahren auf die Entwicklung intelligenter Lösungen spezialisiert: Ich konzipiere und implementiere n8n-Workflows, die Drittanbieter-Anwendungen über REST-APIs und Webhooks verbinden und KI-Komponenten wie LLMs, Agents und RAG in bestehende Prozesse integrieren. Gemeinsam mit Fachabteilungen identifiziere ich Automatisierungspotenziale und setze effiziente Lösungen um – von der Workflow-Entwicklung bis zum Self-Hosting mit Docker. Meine Projekte wie die automatische Spritpreisaktualisierung, die Fremdwörter-KI-Identifizierung oder Turbotube.app zeigen meine Fähigkeit, technische Herausforderungen in praktische, nutzbare Anwendungen zu übersetzen.

Schnellfakten

Aktuelle Position

Aktuell auf Stellensuche

Vorherige Positionen

Technische Umsetzung von Automatisierungs-Workflows bei olympos.ai (Nebenerwerb)
IT-Administration (Windows), IT-Service/Support

Bildung

🎓 HFU Furtwangen, Master of Science (Abschlussarbeit: Predictive Maintenance und Machine Learning)
💻 HFU Furtwangen, Bachelor of Science Medieninformatik

Projekte und Referenzen

🛢️ n8n Workflow zur automatischen Spritpreisaktualisierung in das Tankstellensystem
🤖 Fremdwörter-KI-Identifizierung über Streamlit WebApp
📹 Turbotube.app: YouTube-Video-Transcriptor und KI-Zusammenfassungen mit Kommentaranalyse

Sprachen

🇩🇪 Deutsch (Muttersprache) 🇬🇧 Englisch (B1) 🇸🇪 Schwedisch (A2)

Interessen

🌱 Gärtnern 🔧 Schrauben und Basteln 🎧 Hörbücher 💡 Technikbegeisterung

Meine Projekte

Enterprise RAG (Privates Projekt)

2026

Projektbeschreibung

Design und Aufbau eines Enterprise RAGs. Themen wie Richtlinien und korrekter Kontext sind entscheidend. Besonders die Punkte 3, 4 und 5 sind für ein Enterprise RAG von zentraler Bedeutung.

2. Embeddings & Vektordatenbanken

Wichtige Fragen

  • Welches Embedding-Modell passt zu Ihrer Sprache und Ihrem Fachgebiet?
  • Benötigen Sie mehrsprachige oder domänenspezifische Embeddings?
  • Wie viel Vektorspeicher benötigen Sie und wie schnell müssen Abfragen sein?

Lösungsansatz

Hierzu setze ich auf Mistral OCR und Mistral Embeddings und/oder experimentiere mit lokalen Tools rum.

3. Retrieval-Ebene

Wichtige Fragen

  • Soll die Suche rein auf semantischer Ähnlichkeit basieren oder mit Keyword-Suche kombiniert werden?
  • Wie bewerten wir die Retrieval-Präzision?
  • Können wir nachvollziehen, welche Quellen für jede generierte Antwort verwendet wurden?

Lösungsansatz

Hybrides Retrieval-Modell: semantische Suche + Keyword-Suche. Verwendung von Re-Ranking-Algorithmen oder BM25 + Vektorfusion, um Ergebnisse zu verfeinern. Referenzen von Dokumentenzitate den Ausgaben hinzufügen, um Nachvollziehbarkeit zu gewährleisten.

4. Generationsebene — Kann das LLM den Enterprise-Kontext einhalten?

Wichtige Fragen

  • Welches LLM-Modell: öffentliche API oder On-Premise/privates Modell?
  • Prompt-Vorlagen und Sicherheitsvorgaben?
  • Wie können Halluzinationen und nicht-konforme Ausgaben minimiert werden?

Lösungsansatz

Einsatz eines LLMs in Prompt-Orchestrierungs-Frameworks (LangChain, LlamaIndex).

5. Sicherheit & Compliance: Wo werden sensible Daten verarbeitet?

Wichtige Fragen

  • Wer kann auf welche Dokumente in der Vektordatenbank zugreifen?
  • Wie werden Anmeldedaten und API-Schlüssel gesichert?
  • Welche Audit-Logs beweisen die Einhaltung von Datenschutzrahmenwerken (DSGVO)?

Lösungsansatz

  • Dokumentenebene-Zugriffsrichtlinien in den Retrievern

Problembeschreibung

Normale RAG-Systeme scheitern oft an unternehmensspezifischen Anforderungen: Sie bieten keine ausreichende Kontrolle über den Kontext und erfüllen nicht die strengen Compliance- und Sicherheitsanforderungen, die für sensible Unternehmensdaten notwendig sind.

Mein Lösungsansatz

Verwendete Tools

Langgraph, Langchain

Fazit

Projekt befindet sich noch in der praktischen Umsetzung in Langgraph und Langchain.Es handelt sich um ein Lernprojekt.

n8n Workflow zur automatischen Spritpreisaktualisierung

2025

Projektbeschreibung

Entwicklung eines automatisierten Workflows zur regelmäßigen Aktualisierung von Spritpreisen in einem Tankstellensystem. Der Workflow holt aktuelle Preisdaten von verschiedenen Quellen ab und überträgt diese automatisch in das Tankstellensystem, ohne manuelles Eingreifen.

Problembeschreibung

Tankstellenbetreiber mussten Spritpreise manuell in ihr System eingeben, was zeitaufwendig und fehleranfällig war. Die Preise ändern sich mehrmals täglich, was zu veralteten Daten und verlorenen Einnahmen führen konnte. Es gab keine automatisierte Schnittstelle zwischen den Preisquellen und dem Tankstellensystem.

Mein Lösungsansatz

Ich habe einen n8n-Workflow entwickelt, der:

  • Automatisch Preisdaten von verschiedenen API-Quellen abruft
  • Die Daten filtert, validiert und normalisiert
  • Die aktualisierten Preise über eine Text Datei via FTP in das Tankstellensystem überträgt
  • Bei Fehlern wird eine E-Mail verschickt
  • Viermal täglich läuft der Workflow

Verwendete Tools

n8n REST APIs Datenverarbeitung Automatisierung

Fazit

Der Workflow spart wöchentlich mehrere Stunden manuelle Arbeit und stellt sicher, dass die Spritpreise immer aktuell sind. Die Fehlerquote wurde auf fast 0% reduziert, und der Tankstellenbetreiber kann sich auf sein Kerngeschäft konzentrieren.

Fremdwörter-KI-Identifizierung

2025

Projektbeschreibung

Eine Streamlit-WebApp, die mit KI fremde oder schwierige Wörter in Texten identifiziert und deren Bedeutungen erklärt. Die Anwendung ist besonders nützlich für Buchverlage.

Problembeschreibung

Beim Lesen von Fachtexten, wissenschaftlichen Artikeln oder juristischen Dokumenten stößt man häufig auf unbekannte Fremdwörter oder Fachbegriffe. Die manuelle Suche nach jedem unbekannten Begriff ist zeitraubend und unterbricht den Lesefluss.

Mein Lösungsansatz

Ich habe eine Streamlit-WebApp für den Gmeiner Verlag entwickelt, die:

  • Texte analysiert und Fremdwörter automatisch erkennt
  • Kontextbasierte Definitionen liefert
  • Synonyme und verwandte Begriffe vorschlägt
  • Eine benutzerfreundliche Oberfläche für die Textanalyse bietet
  • Ergebnisse in Echtzeit liefert
  • KI-Modelle (LLMs) zur genauen Identifizierung nutzt

Verwendete Tools

Streamlit Python KI-Modelle (LLMs) Web-Interface

Fazit

Die Anwendung beschleunigt die Identifizierung von Fremdwörtern erheblich und Hilft damit Lektoren.

Turbotube.app

2025 - 2026

Projektbeschreibung

Eine Webanwendung, die YouTube-Videos in Text transkribiert und dann mithilfe von KI automatische Zusammenfassungen sowie eine Analyse der Kommentare erstellt. Ideal für Content-Creator, Forscher und Journalisten.

Problembeschreibung

Die Analyse von YouTube-Inhalten war bisher sehr aufwendig: Videos mussten manuell transkribiert werden, und die Auswertung der oft umfangreichen Kommentarsektion war kaum machbar. Wichtige Erkenntnisse aus Videos und Community-Feedback gingen oft verloren.

Mein Lösungsansatz

Turbotube.app bietet:

  • Automatische Transkription von YouTube-Videos in Text
  • LLM-gestützte Zusammenfassungen der Videoinhalte
  • Sentiment-Analyse der Kommentare
  • Themenextraktion aus Kommentaren
  • Stichwortbasierte Suche in transkribierten Inhalten
  • Exportfunktionen für weitere Analyse

Verwendete Tools

YouTube API LLM-Zusammenfassung mit Mistral Model Sentiment-Analyse Python FastAPI Next.js

Fazit

Turbotube.app revolutioniert die YouTube-Content-Analyse. Content-Creator können nun schnell Videoinhalte und Community-Feedback verstehen, ohne stundenlang Videos anzusehen oder Kommentare manuell durchzulesen. Die Anwendung spart Zeit und liefert wertvolle Erkenntnisse.

Tech Stack

Implementation toolkit supporting product-engineering work—languages, frameworks, data, AI/ML, and engineering software I use to ship features end to end.

Programming Languages

Python
Python
JavaScript
JavaScript
TypeScript
TypeScript

Web Fundamentals

HTML
HTML
CSS
CSS
Tailwind CSS
Tailwind CSS

Query Languages

SQL
SQL
NoSQL

Backend Frameworks

Flask API
Flask API

Frontend Frameworks

React
React
Next.js
Next.js
Streamlit
Streamlit

IT-Administration

Windows Clients und Server
MDM baramundi und InTune
FortiGate Firewall
M365
M365

AI/ML Frameworks

Scikit-learn
Scikit-learn
Ollama
Ollama
LangChain
LlamaIndex

Vector Stores

Pinecone
ChromaDB

Development Tools

Git
Git
GitHub
GitHub
GitLab
GitLab
VSCode
VSCode
Linux
Linux
Arch Linux
Arch Linux
Docker
Docker
Jupyter
Jupyter
GCP
GCP
Postman
Postman
Nginx
Nginx
Hugo
Hugo

Databases

PostgreSQL
PostgreSQL
SQLModel
MySQL
MySQL
MongoDB
MongoDB
Supabase
Supabase

Kontaktieren Sie mich

Schicken Sie mir eine Nachricht

Kontaktinformationen

Let's connect! I'm always interested in hearing about new projects and opportunities.